epub1t 📚⚡: Pipeline Chuyển Đổi & Nén Sách Điện Tử 1-Bit Siêu Tốc Cho Máy Đọc Sách E-ink
Quy trình tối ưu sách điện tử 1-bit cho màn hình E-ink.
 Đinh Toàn Trung (Zed)
Mục lục
“Một chiếc máy đọc sách e-ink sinh ra để bạn chìm đắm vào trang sách, chứ không phải để ngồi chờ từng giây lật trang nặng nhọc hay vật lộn với những dòng chữ nhảy loạn xạ vì lỗi mã hóa font cổ.”— Đinh Toàn Trung (Zed) • Triết lý phát triển epub1t
Bất kỳ ai sử dụng máy đọc sách Kindle, Kobo hay Boox đều từng gặp phải hai "cơn ác mộng" kinh điển:
- Sách scan định dạng PDF quá nặng: Những cuốn sách hàng trăm megabytes khiến bộ nhớ máy nhanh đầy, pin sụt nhanh chóng và mỗi lần lật trang đều bị giật đơ (lag), chữ nhòe nhoẹt vì nền giấy ố vàng.
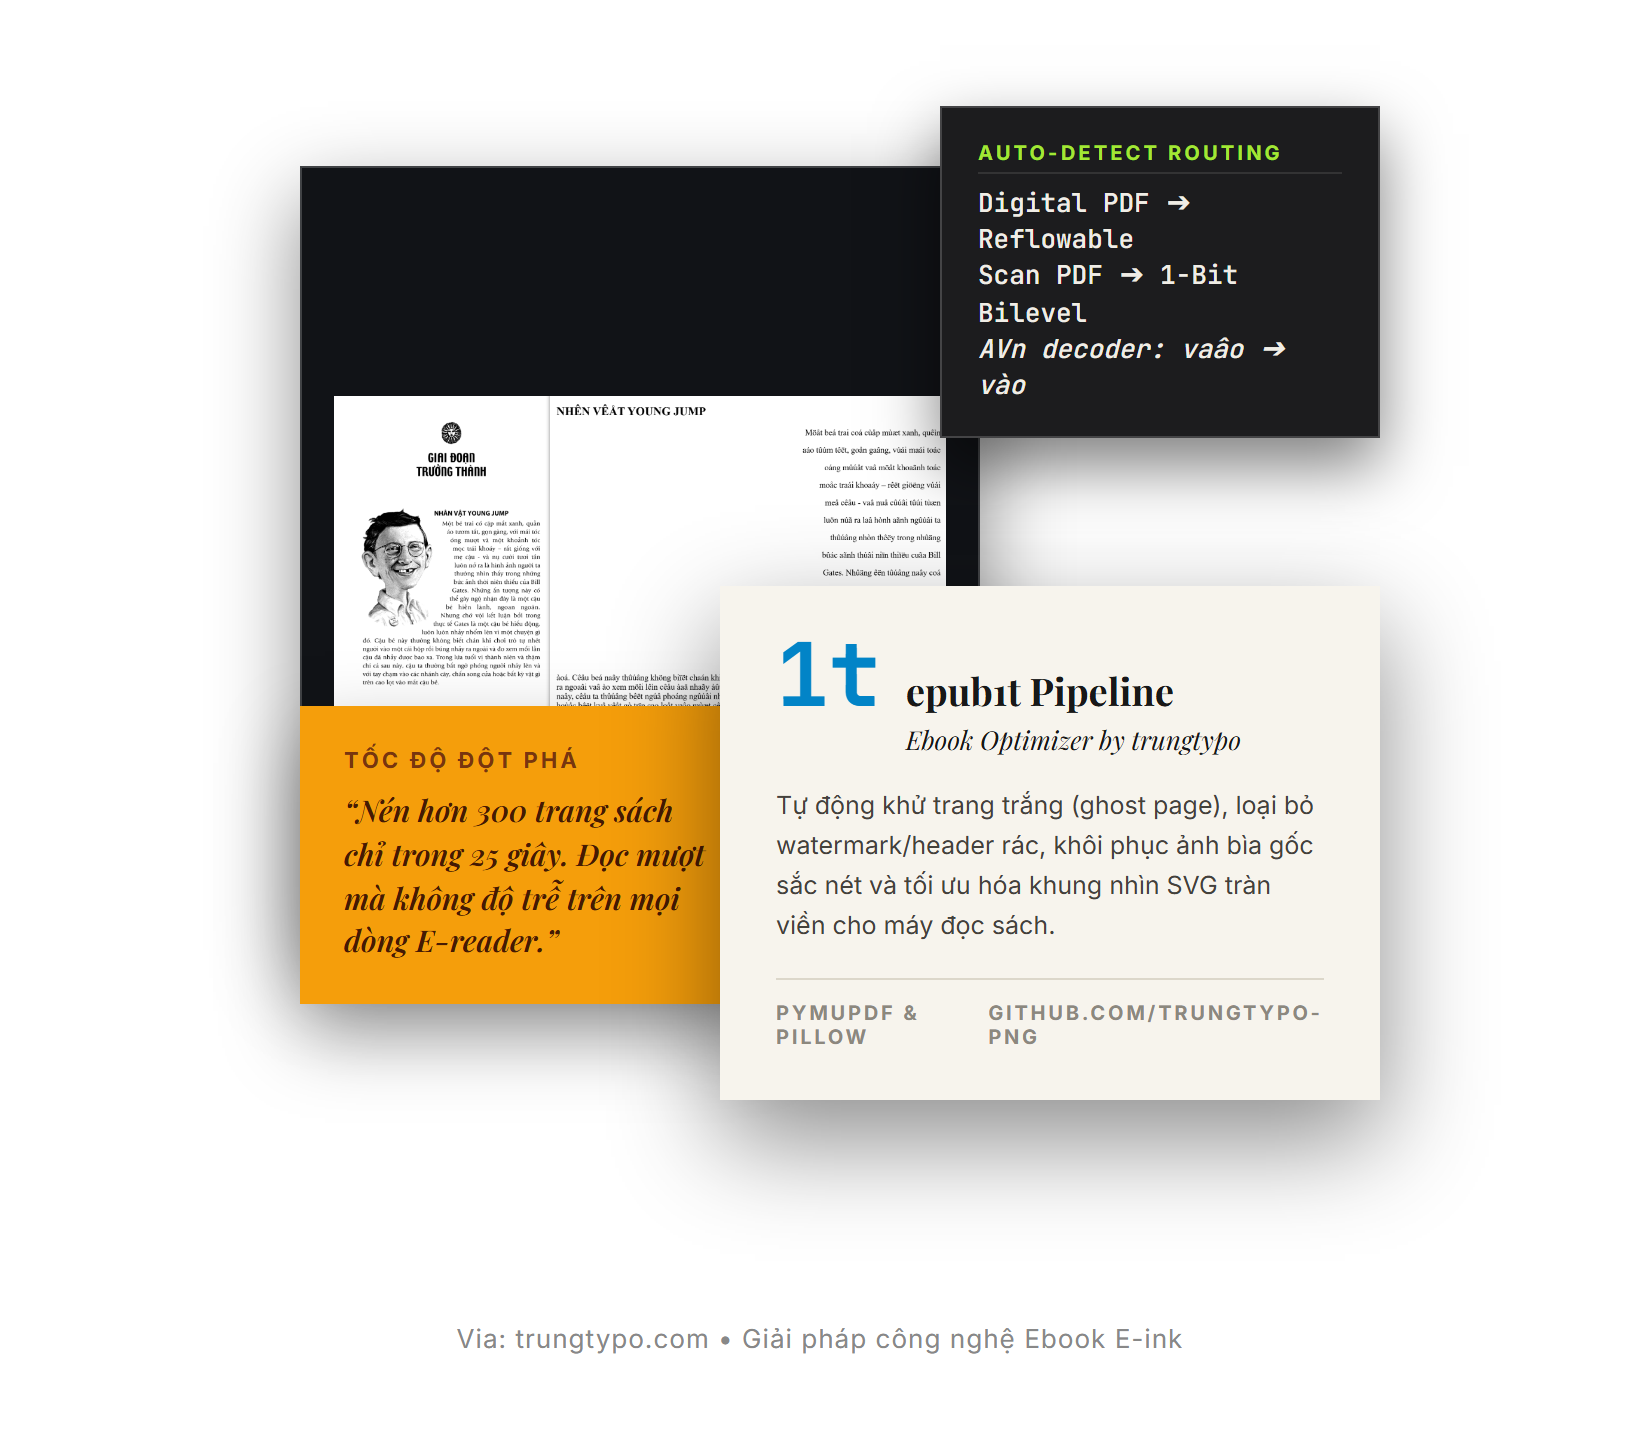
- PDF số hóa cũ bị lỗi font tiếng Việt: Các tài liệu xuất bản thời kỳ 1990–2005 sử dụng bảng mã AVn, VNI hoặc TCVN3 khi xuất sang EPUB thường xuyên bị lỗi nhảy dấu nghiêm trọng (ví dụ
vaâo ➔ vào,ngöôøi ➔ người).
Để giải quyết triệt để hai bài toán này, dự án mã nguồn mở epub1t được xây dựng như một cỗ máy tự động hóa hoàn chỉnh, kết hợp sức mạnh xử lý ảnh nhị phân với thuật toán bóc tách văn bản thông minh.
trungtypo-png / epub1t
Kho mã nguồn mở trên GitHub cung cấp sẵn bản dựng Standalone App chạy ngay cho Windows & macOS (không cần cài Python) cùng bộ công cụ CLI mạnh mẽ cho lập trình viên.
01 / Kiến Trúc Động Cơ Kép (Dual Processing Engines)
Điểm đột phá nhất của epub1t là khả năng tự động nhận diện cấu trúc tệp (Auto-Detect Routing) để chuyển hướng xử lý:
Động cơ 1-Bit Bilevel
Dành riêng cho scanned PDF / truyện tranh. Sử dụng thuật toán Zero-Copy Direct Buffer, nén 300 trang sách trong chưa đầy 25 giây, đưa dung lượng giảm 80–90% mà chữ nét như in khắc.
Động cơ Reflowable Text
Bóc tách luồng văn bản bằng PyMuPDF, cho phép tùy chỉnh cỡ chữ, phông nền Dark Mode và hiển thị mục lục phân cấp sâu (Hierarchical TOC).
Bộ giải mã Font AVn / VNI
Tự động nhận diện và chuyển hóa toàn bộ các lỗi nhảy dấu tiếng Việt cổ thời tiền 2005 về chuẩn Unicode hiện đại mượt mà.
Tối ưu hóa phần cứng E-ink
Khung nhìn SVG tràn viền (Full-Viewport SVG), tự động tẩy trắng nền ố vàng và khử sạch nhiễu hạt bụi giấy.
02 / Bảng Kỷ Lục Hiệu Năng & Nén Dung Lượng Thực Tế
Thử nghiệm thực chiến trên các bộ tài liệu đồ sộ cho thấy hiệu quả vượt trội so với các công cụ chuyển đổi truyền thống như Calibre hay KCC:
Benchmark nén sách scan thực tế
- Sách scan 300 trang: Dung lượng gốc >100 MB ➔ Sau khi nén còn ~22 MB (Giảm 78%).
- Tác phẩm scan 765 trang: Dung lượng gốc >200 MB ➔ Sau khi nén còn 25.51 MB (Giảm 87%, tương đương chỉ ~33 KB/trang).
- PDF văn bản lỗi font AVn: Bị lỗi mã hóa ➔ Chuyển thành Reflowable EPUB chuẩn sắc nét < 1 MB.
03 / Các Tính Năng Thông Minh Khác
- Tự động sửa chiều âm bản (Auto-Polarity Guard): Phát hiện và đảo chiều thông minh các trang scan bị chụp ngược sáng hoặc scan âm bản trắng chữ đen.
- Khôi phục bìa sách thực (Real Cover Restoration): Thay thế hoàn toàn bìa mặc định khô cứng bằng trang bìa chuẩn nét của tác phẩm.
- Khử trang ma (Ghost Page Cleaner): Tự động loại bỏ các trang trắng đệm không cần thiết sinh ra trong quá trình xuất bản.
- Lọc sạch Watermark & Header rác: Xóa bỏ số trang thừa thãi, dòng tiêu đề running header và dấu bản quyền của các website chia sẻ lậu mà không làm đứt gãy mạch đọc.
04 / Hướng Dẫn Sử Dụng Nhanh
Người dùng không rành công nghệ có thể tải trực tiếp file zip trong mục Releases, giải nén và nhấp đúp vào file chạy có giao diện đồ họa trực quan (GUI):
# Cài đặt và chạy từ mã nguồn Python:

git clone https://github.com/trungtypo-png/epub1t.git

cd epub1t

pip install -r requirements.txt

python gui.pyTrải nghiệm công nghệ nén sách đỉnh cao
Toàn bộ mã nguồn, tài liệu và các bản phát hành mới nhất đều được cập nhật thường xuyên tại GitHub: